Resumen
La Inteligencia Artificial Generativa se ha intentado posicionar a partir de 2022 como un fenómeno tecnológico autónomo. Este ensayo propone un reencuadre: la IA generativa es una industria con dependencias materiales concretas (energía, agua, semiconductores, trabajo humano) que constituyen externalidades estructurales y, simultáneamente, puntos de intervención regulatoria. A partir de un análisis documental de reportes técnicos, datos de consumo e investigaciones empíricas, el artículo documenta la cadena extractiva que sostiene a la industria, examina cómo la burbuja de inversión especulativa amplifica esas externalidades, y propone palancas de gobernanza para América Latina: regulación de infraestructura cloud como servicio público, marcos para datos de entrenamiento y trabajo, alternativas técnicas abiertas, y acción colectiva de la sociedad civil y formación. La región es simultáneamente marginal como productora de IA y expuesta como proveedora de los recursos (electricidad, agua, minerales, mano de obra) que la hacen posible; esa posición la obliga a accionar las palancas de gobernanza que tiene a su alcance.
Abstract
Generative artificial intelligence has been positioned since 2022 as an autonomous technological phenomenon. This essay proposes a reframing: generative AI is an industry with concrete material dependencies—energy, water, semiconductors, human labor—that constitute structural externalities and, simultaneously, points of regulatory intervention. Through a documentary analysis of technical reports, consumption data, and empirical research, the article documents the extractive chain that sustains the industry, examines how the speculative investment bubble amplifies those externalities, and proposes governance levers for Latin America: regulation of cloud infrastructure as a public utility, frameworks for training data and labor, open technical alternatives, and civil-society collective action and education. The region is simultaneously marginal as an AI producer and exposed as a supplier of the resources—electricity, water, minerals, labor—that make it possible; this position compels it to activate the governance levers within its reach.
Resumo
A inteligência artificial generativa tem sido posicionada a partir de 2022 como um fenômeno tecnológico autônomo. Este ensaio propõe um reenquadramento: a IA generativa é uma indústria com dependências materiais concretas —energia, água, semicondutores, trabalho humano— que constituem externalidades estruturais e, simultaneamente, pontos de intervenção regulatória. A partir de uma análise documental de relatórios técnicos, dados de consumo e pesquisas empíricas, o artigo documenta a cadeia extrativa que sustenta a indústria, examina como a bolha de investimento especulativo amplifica essas externalidades e propõe alavancas de governança para a América Latina: regulação da infraestrutura de nuvem como serviço público, marcos para dados de treinamento e trabalho, alternativas técnicas abertas e ação coletiva da sociedade civil e formação. A região é simultaneamente marginal como produtora de IA e exposta como fornecedora dos recursos —eletricidade, água, minerais, mão de obra— que a tornam possível; essa posição a obriga a acionar as alavancas de governança ao seu alcance.
1. Introducción
En noviembre de 2022, millones de personas interactuaron por primera vez con un modelo de lenguaje conversacional. La experiencia fue tan fluida que se instaló con rapidez un relato dominante, según el cual la inteligencia artificial recién entonces llegaba. Pero la IA no se inventó en 2022: no solamente el término tiene 70 años (McCarthy et al. 1955), sino que no era la primera vez que llegaba al mercado: correctores gramaticales, filtros de spam, recomendaciones de Amazon, entre otros, ya eran IA. Lo que cambió fue tanto la escala (de extracción, consumo y especulación) como el relato.
Ese relato, difundido por las principales empresas del sector —Microsoft, Amazon, Nvidia, Google y OpenAI han construido su oferta comercial en torno al vocabulario de la autonomía—, su aparato de marketing y buena parte de la prensa tecnológica, desmaterializa el fenómeno y lo presenta como autónomo. Rainer Rehak (2025), investigador del Instituto Weizenbaum para la Sociedad en Red, analiza ese vocabulario y muestra que términos como “autonomía” o “agencia” operan como recursos de marketing antes que como descripciones técnicas: un sistema “autónomo” sigue requiriendo que sus objetivos y reglas se fijen desde afuera. El lenguaje corporativo lo refuerza cuando describe agentes que “trabajan 24/7, no necesitan almuerzo ni prestaciones” (Volenik, 2025), e invisibiliza que esos sistemas consumen electricidad, agua, minerales y trabajo humano cuyos costos recaen sobre territorios concretos. Como observa Muro (2021), las metáforas “se fosilizan en los argumentos hasta que olvidamos que […] moldean la forma en que nos acercamos al mundo”. Hablar de “la nube” refuerza una concepción inmaterial. Frente a ese relato que presenta la IA como una fuerza natural, este artículo propone un reencuadre: la IA generativa es una industria que requiere permisos de agua, contratos laborales y licitaciones públicas que alguna autoridad debe otorgar o denegar. Esos puntos de fricción son las palancas que los Estados y actores regionales pueden activar para condicionar cómo opera esa industria en su territorio.
El marco proviene de los estudios de infraestructura y del Atlas of AI de Crawford (2021;2022), quien propone entender la IA como ensamblaje material antes que como artefacto técnico: “la minería de extracción que deja una huella en el planeta, la captura masiva de datos y las prácticas laborales profundamente desiguales” (p. 33), y desplaza la atención del algoritmo al sistema que lo sostiene; en su análisis, las externalidades son condiciones de funcionamiento del sistema y no fallas corregibles. Plantin et al. (2018) mostraron que las plataformas digitales adquieren características de infraestructura sin los marcos regulatorios que históricamente las acompañaron; quien controla la infraestructura digital condiciona lo que se puede hacer con ella: lo que Ortiz Freuler (2025) analiza como puntos de control, los mecanismos y junturas de la arquitectura y la gobernanza de internet que permiten a quien los controla modular, restringir o moldear los flujos de información, y con ello determinar las condiciones de acceso, uso y desarrollo de sistemas de los que dependen sectores enteros de la economía y la sociedad. Juntos, estos marcos[1] desplazan la pregunta de “¿qué puede hacer la IA?” hacia “¿quién controla la infraestructura que la hace posible, y bajo qué condiciones?”
A esa crítica infraestructural se suma una epistemológica. Bender, Gebru et al. (2021) describieron los modelos como “loros estocásticos”: sistemas que “ensamblan de forma azarosa secuencias de formas lingüísticas […] según información probabilística sobre cómo se combinan, pero sin ninguna referencia al significado”. Su contribución central sigue vigente: la tendencia de los interlocutores humanos a atribuir significado donde no lo hay no equivale a que estos sistemas comprendan, y asumir que la escala resolverá estas limitaciones tiene costos ambientales y sociales desproporcionados. Este artículo retoma el concepto y considera la dimensión material, refiriéndose a los sistemas de IA generativa como loros de silicio.
América Latina enfrenta el fenómeno desde una posición vulnerable. Representa apenas el 1,56% del gasto mundial en IA (Jung y Katz, 2025), pero sus recursos naturales, su mano de obra y la limitada regulación específica la dejan particularmente expuesta como territorio receptor de la infraestructura que sostiene la industria y como proveedora de los recursos —electricidad, agua, mano de obra— que la hacen posible.
Utilizamos externalidades en su sentido económico clásico: costos transferidos a terceros que no participaron en la decisión (Pigou, 1920). Cuando un centro de datos consume el agua de una comuna agrícola, el costo hídrico es una externalidad. Cuando un anotador de datos filtra contenido violento sin acompañamiento psicológico, el daño a su salud mental es una externalidad.
Metodológicamente, este trabajo es un ensayo de revisión documental con enfoque de economía política de la infraestructura; no busca establecer relaciones causales empíricas; reencuadra conceptualmente un fenómeno a partir de evidencia ya disponible. El corpus reúne reportes técnicos, datos de consumo de la industria, informes de organismos internacionales, investigación académica y periodismo de investigación. Los casos se seleccionaron por su capacidad para ilustrar cada eslabón de la cadena de suministro de la IA generativa —Quilicura y la Patagonia para energía, Querétaro para agua, las minas de cobre andinas y la cuarcita brasileña para minerales, Kibera y los testimonios del Data Workers’ Inquiry para trabajo— y por documentar situaciones latinoamericanas o directamente comparables a la posición de la región. El alcance es conceptual y regional; su principal limitación es que la opacidad de la industria impide cuantificar con precisión varias externalidades, de modo que el argumento se apoya en estimaciones convergentes antes que en cifras únicas. A lo largo del texto se distingue, cuando resulta pertinente, entre cifras provenientes de investigación académica, de informes institucionales y de la propia industria o el periodismo especializado, cuyos grados de verificación son desiguales.
De este reencuadre se desprende la tesis que organiza el ensayo. Si las dependencias materiales de la IA generativa son los puntos donde la industria requiere permisos, contratos y recursos, entonces constituyen puntos de intervención política, y América Latina dispone de palancas concretas para accionarlos. Dos preguntas guían el análisis: qué implicaciones tiene para la soberanía digital de la región su dependencia de proveedores globales de IA, y cómo transforma esta industria las capas de infraestructura sobre las que se asienta y con qué efectos para los territorios que aportan sus recursos materiales.
El argumento se desarrolla recorriendo la cadena extractiva desde la energía hasta el trabajo humano, examina el papel de la burbuja de inversión como amplificador de las externalidades y propone cuatro palancas de gobernanza para la región: regulación de la infraestructura cloud, marcos para datos de entrenamiento y trabajo, alternativas técnicas abiertas, y acción colectiva de la sociedad civil y formación.
2. Dependencias materiales: la cadena extractiva
La cadena de suministro de la IA generativa puede rastrearse desde la energía, el agua y los minerales hasta el trabajo humano que la afina. Crawford (2021;2022) documenta un patrón histórico que ilumina esta dinámica extractiva: “Las minas estaban ubicadas lejos de la ciudad que enriquecían, y esta lejanía permitió a sus ciudadanos seguir ignorando lo que les ocurría a las montañas, a los ríos y a los trabajadores que alimentaban sus fortunas” (p. 54). Hoy la distancia es aún mayor: los centros de datos que alimentan la IA se instalan en Chile, Uruguay o México, mientras las ganancias se concentran en un puñado de corporaciones con sede en Estados Unidos y China. Las secciones que siguen recorren esa estructura de abajo hacia arriba.
2.1 Energía y cómputo
La etapa de entrenamiento del modelo GPT-4 de OpenAI requirió del orden de 51.000–62.000 MWh (equivalente, según cálculo propio, al consumo anual de 20.000–25.000 hogares mexicanos) (Ludvigsen, 2023). El costo de entrenar modelos de frontera —los de mayor capacidad en cada momento— crece 2,4 veces por año (Cottier et al., 2024); proyecciones recientes sitúan en torno a mil millones de dólares el entrenamiento del modelo más caro hacia 2027 (Cottier et al., 2024). La fase de producción de un modelo (llamada entrenamiento) es un evento puntual, mientras que la inferencia —el uso del modelo para generar respuestas o hacer trabajo— genera consumo permanente durante toda su vida útil (Jegham et al., 2025): 0,42 Wh por consulta a GPT-4o, los propios autores proyectan para 2025 entre 391.509 y 463.269 MWh anuales, más que el consumo eléctrico de 35.000 hogares estadounidenses.
La respuesta de la industria ha sido asegurar el suministro antes que reducir el consumo: Amazon ha anunciado centros alimentados por energía nuclear de 1.000 MW; Google, Microsoft y OpenAI planifican clusters superiores al gigavatio (Patel et al., 2024). Este patrón es consistente con la paradoja de Jevons (Alcott, 2005): la eficiencia por consulta mejora, pero la demanda agregada crece más rápido y el consumo absoluto aumenta.
La escala se amplifica por la concentración del mercado cloud: sectores enteros de la economía —finanzas, salud, telecomunicaciones, sector público— ya dependen de la infraestructura de unos pocos hyperscalers (Ofcom, 2023; von Thun y Colville, 2026); la expansión de la IA generativa sobre esa misma infraestructura añade una nueva capa de consumo energético cuyo crecimiento convierte el problema en sistémico antes que sectorial. Solo los sistemas de IA podrían haber emitido entre 32,6 y 79,7 millones de toneladas de CO₂ en 2025 (De Vries-Gao, 2025). La capacidad instalada de centros de datos de IA alcanzó 29,6 GW en 2025, comparable al pico de demanda del estado de Nueva York (Stanford HAI, 2026).
En América Latina la infraestructura es extranjera pero los costos locales: en Quilicura (Chile) un complejo consume 80% de la electricidad industrial de la zona, según la plataforma de documentación socioambiental DataCenter Boom (2026); OpenAI y Sur Energy firmaron en 2025 intención de construir un centro de 500 MW en la Patagonia argentina, con inversión proyectada de hasta 25 mil millones de dólares, atraída por la energía eólica y solar de la región y por los beneficios fiscales del RIGI (OpenAI, 2025; Reuters, 2025). Sin expansión equivalente de la red, la electricidad que alimenta los servidores deja de estar disponible para otros usos locales.
2.2 Agua
Los centros de datos requieren cantidades masivas de agua para su enfriamiento. Aunque las estimaciones del consumo de agua por consulta varían (entre 0,3 y 500 ml) según qué se mida y quién mida —los valores más bajos suelen provenir de las propias empresas (DataCenter Dynamics, 2025) y los más altos de análisis independientes (Li et al., 2023; Goedecke, 2024)—, la escala agregada es enorme: centros medianos consumen hasta 416.000 m³/año y los más grandes 19.000 m³/día (EESI, 2025), equivalente al consumo de una localidad mexicana de 50.000 habitantes. Proyecciones para Estados Unidos sitúan la huella hídrica anual de servidores de IA entre 731 y 1.125 millones de m³ entre 2024 y 2030 (Xiao et al. 2025). A escala corporativa, Google consumió 31 mil millones de litros en sus centros de datos y oficinas en 2024; su consumo total de agua creció un 28% interanual, y el 72% de sus extracciones provino de fuentes con bajo riesgo de escasez hídrica (Google, 2025). Solo la inferencia anual de GPT-4o —el modelo conversacional de OpenAI predominante en 2024, ya retirado— podía superar el consumo de agua potable de 1,2 millones de personas (Stanford HAI, 2026).
Existen alternativas técnicas (enfriamiento por inmersión, circuitos cerrados, aire acondicionado) aunque cada una desplaza el costo: el aire acondicionado elimina el consumo de agua pero incrementa el eléctrico, lo que en una matriz basada en combustibles fósiles agrava la huella de carbono — y no en una renovable. El enfriamiento por evaporación es más barato y la industria migra hacia él por su menor consumo eléctrico; el trade-off es que se evaporan grandes volúmenes de agua. Las empresas buscan ubicaciones sin regulación específica de consumo hídrico y consiguen permisos que les permiten extraer cantidades masivas de agua, transfiriendo ese recurso de personas y agricultura a centros de datos (Barringer, 2025; Baptista y McDonnell, 2025). En Querétaro (México), donde se concentra 65% de la capacidad nacional de centros de datos (Ricaurte y Roldán, 2025), una unidad de Microsoft en Colón consume 25.000 m³/año —24% del agua asignada al municipio— en una zona cuyo acuífero, el del Valle de San Juan del Río, ya arrastra un déficit de 56,8 millones de m³ (Baptista y McDonnell, 2024); en un estado donde la demanda ya supera el 80% del agua naturalmente disponible (Kuzma et al., 2023), en 2024, tras dos años de sequía, el 96% del territorio llegó a estar en sequía excepcional (Conagua-SMN, 2024) y CONAGUA, que desde 2015 advertía el déficit de cuatro acuíferos del estado, había recomendado no otorgar más permisos (Medina et al., 2025; DataCenter Boom, 2025). CONAGUA sostiene que no otorgó nuevas concesiones y que Microsoft compró la suya a otro titular, de modo que la extracción creció sin que mediara un permiso nuevo (Baptista y McDonnell, 2024); los centros en parques industriales están exentos de presentar manifestación de impacto ambiental porque se construyen en parques que fueron aprobados previamente (Baptista y McDonnell, 2025). La investigación de Ricaurte y Roldán (2025) sobre lo que las autoridades llaman “el valle de los centros de datos” (que concentra más del 80% de la inversión del sector en México) subraya que el consumo hídrico de estas instalaciones es opaco por diseño, ya que las concesiones se transfieren dentro de los parques industriales y las autoridades rechazan transparentar los volúmenes asignados a cada empresa; el dato necesario para cualquier regulación efectiva no existe públicamente. Vecinos de las comunidades de Viborillas y La Esperanza reportan cortes de agua y luz que atribuyen a los centros de Microsoft y Ascenty (testimonios recogidos por Baptista y McDonnell, 2026). En Quilicura (Chile) se concentra la mayor aglomeración de centros de datos de América Latina; los de mayor escala (Ascenty, Google, Microsoft y Sonda) consumen en conjunto 1.500 millones de litros al año, y Google mantiene derechos de extracción de 50 litros por segundo, equivalentes al consumo anual de unos 8.500 hogares, mientras el humedal de Quilicura se seca, según un reportaje de investigación de The Guardian con trabajo de campo en la zona (2026).
2.3 Semiconductores
Toda la industria de los chips depende de dos cuellos de botella geográficos: ASML (Holanda) concentra el monopolio de facto de las máquinas de litografía ultravioleta extrema, sin las cuales es imposible fabricar chips de última generación; TSMC (Taiwán) concentra más del 70% de la fabricación por contrato de chips, incluyendo prácticamente todos los chips de IA avanzados, lo que hace que la cadena global de suministro de hardware de IA dependa de una sola fundidora (VerWey, 2024; TrendForce, 2025; Stanford HAI, 2026).
La demanda de minerales se proyecta que se duplicará hacia 2030 en el escenario de transición energética (IEA, 2024). El silicio elemental no existe en la naturaleza, proviene de depósitos de cuarzo y cuarcita de alta pureza; la extracción tiene lugar principalmente en Estados Unidos, China, Brasil, Australia, entre otros (USGS, 2024); otros elementos necesarios son el cobre, el aluminio, el galio, el germanio y el antimonio, que comparten con la movilidad eléctrica y las redes de transmisión cuellos de botella de refinación y plazos de suministro (World Economic Forum, 2025). Chile y Perú son los dos principales productores de cobre —más de un tercio de la producción mundial (USGS, 2024b)—; el aluminio también se refina a partir de la bauxita, cuya producción mundial lideran Australia, Guinea y China, mientras Jamaica y Brasil son los proveedores principales del mercado estadounidense (USGS, 2024c). Para semiconductores y electrónica, China concentra la refinación de 19 de cada 20 minerales estratégicos (IEA, 2025). Las prohibiciones de exportación de galio, germanio y antimonio que impuso a Estados Unidos en diciembre de 2024 (IEA, 2025) son la aplicación más reciente de esa lógica.
Considerando el ciclo completo, estos materiales podrían reciclarse en vez de extraerse; sin embargo, aunque el reciclaje ya evita la extracción de 900.000 millones de kilogramos de mineral en bruto (ITU y UNITAR, 2024), las tierras raras apenas cubren un 1% de la demanda vía reciclaje porque su concentración en los residuos electrónicos es tan baja que no resulta económicamente viable (ITU y UNITAR, 2024). Solo una quinta parte de los residuos electrónicos se recicla; en América Latina se recoge y procesa en condiciones ambientalmente racionales apenas el 2,7%, y más del 97% de los residuos electrónicos ni se recoge ni llega a instalaciones de gestión ambientalmente racional, con lo que se pierden unos 1.700 millones de dólares en materias primas secundarias (ITU y UNITAR, 2024; Wagner et al., 2022).
Impactos locales
Las prohibiciones de exportación y la concentración en pocos nodos dejan a regiones enteras a merced de decisiones geopolíticas. Para América Latina, que no fabrica semiconductores ni opera grandes proveedores de infraestructura cloud (hyperscalers) propios, la dependencia de las cadenas de producción internacionales es, en el estado actual, prácticamente completa, aunque existen márgenes de intervención regulatoria, como se desarrollará más adelante. En los eslabones donde la región sí participa —como proveedora de minerales— los impactos ambientales y sociales son concretos: los relaves de minas de cobre en Chile y Perú contaminan suelos y cuencas con arsénico, plomo y cobre cuando las presas colapsan o se infiltran, causando graves afectaciones de salud para la población local (Cacciuttolo y Cano, 2022). En Brasil, la mina MRN en Oriximiná descargó al Lago Batata unos 24 millones de toneladas de residuos durante una década, destruyendo la fauna del lago, principal fuente de alimentación de comunidades quilombolas y causando afecciones dérmicas persistentes (Borges y Branford, 2020). También en Brasil, la mina de cuarzo en Ouro Preto causa contaminación de la tierra, el agua y el aire además de enfermedades respiratorias crónicas, cáncer y silicosis (Leite y Gonçalves-Fujaco, 2013) y la fundición de antimonio en Vinto (Bolivia), está vinculada a contaminación por arsénico y plomo que supera límites FAO/OMS (Rötting et al., 2014). Como señala Ortiz-Freuler (2026), la soberanía informacional de la región está comprometida porque la infraestructura física de la que depende está en manos de un puñado de empresas extranjeras sujetas a la jurisdicción y los intereses geopolíticos de sus países de origen.
2.4 Trabajo humano
Detrás de cada promocionada mejora al rendimiento de los modelos hay trabajadores —la mayoría en el sur global— que clasifican contenido, etiquetan datos y filtran material violento. Gray y Suri (2019) le pusieron nombre: ghost work, trabajo fantasma, porque permanece invisible tras la interfaz: aproximadamente 20 millones de personas trabajando aisladas, sin beneficios, sin protección laboral clara. La computación a gran escala está profundamente enraizada en la explotación de cuerpos humanos; de hecho, funciona gracias a ellos (Crawford, 2021;2022, p. 96).
Un reportaje de Isobel Cockerell con Christopher Wylie, el denunciante de Cambridge Analytica, documentó esa cadena en Nairobi (Cockerell, 2025). En Kibera, el asentamiento informal más grande de África, un joven llamado Felix estimó que siete u ocho de cada diez personas de su generación en el barrio han trabajado para Sama, la empresa que reclutó y entrenó allí a trabajadores digitales para clientes como Meta y OpenAI, en un proceso que replican todas las grandes tecnológicas, de TikTok a Google; en las afueras de la ciudad, Mercy Chimwani, moderadora de contenido para Meta a través de una empresa intermediaria por unos 180 dólares mensuales, vivía en una casa a medio construir, sin electricidad y con el agua corriendo por dentro cuando llovía; en 2024, trabajadores en Kenia publicaron una carta abierta: “nuestras condiciones equivalen a esclavismo moderno” (Pogrebna, 2024). En el contexto del proyecto Data Workers’ Inquiry (Miceli, 2023) con coinvestigadores en Kenia, Siria, Argentina, Brasil y Alemania; Oskarina Fuentes Anaya testificó ante el Parlamento Europeo que las microtareas de etiquetado de datos son pagadas entre 1 y 5 centavos, y pidió que las plataformas tomen en cuenta a las trabajadoras “no sólo como herramientas de trabajo que pueden desechar cuando ya no les sirvamos, sino como seres humanos que ayudamos en su avance tecnológico” (Fuentes Anaya, 2024).
La explotación es estructural; forma parte de cómo opera la industria. Mercy Mutemi, abogada de más de 180 moderadores de contenido en un litigio contra Sama y Meta, lo describe como “una nueva forma de colonización, en la que solo hay extracción de recursos y no vuelve lo suficiente en términos de valor: invertir en las personas, en su bienestar, o simplemente pagar salarios decentes” (Cockerell, 2025). El daño psicológico que sufre quien filtra ese contenido sin acompañamiento es, una vez más, un costo que la industria no internaliza. Esa invisibilidad fue nombrada también por la doctrina social de la Iglesia. La encíclica Magnifica Humanitas (León XIV, 2026) reconoce en su párrafo 109 el “trabajo invisible, a menudo explotado, que alimenta los modelos algorítmicos”, y sostiene en el 108 que la propiedad de los datos “no puede confiarse sólo al sector privado” porque son “fruto del aporte de muchos”.
3. La burbuja como amplificador de externalidades
Las externalidades tratadas en la sección anterior se ven amplificadas por un fenómeno de burbuja de inversión especulativa de proporciones históricas, una caracterización que la evidencia de esta sección respalda y que, como se verá más abajo, comparten varios protagonistas de la propia industria. Se proyectaba que las grandes tecnológicas estadounidenses invirtieran más de 400 mil millones de dólares en infraestructura de IA en 2025 (IEEE ComSoc, 2025; Thompson, 2025), y las proyecciones indican que el gasto de capital de los cinco grandes proveedores de nube (Microsoft, Google, Amazon, Meta y Oracle) podría llegar a 780 mil millones de dólares en 2026 (Bain & Company, 2026); la inversión corporativa total en IA —incluyendo adquisiciones, participaciones minoritarias e IPOs— alcanzó 581,7 mil millones de dólares en 2025, un 130% más que el año anterior (Stanford HAI, 2026). Los consumidores de todo el mundo gastan en servicios de IA unos 40 mil millones de dólares al año, el triple que en 2025 pero todavía una fracción de lo invertido en infraestructura (Menlo Ventures, 2026). El MIT encontró que el 95% de las organizaciones no lograron retorno sobre la inversión en IA generativa (Challapally et al., 2025); encuestas a CEOs coinciden en la ausencia de impacto medible en productividad. Sólo el 12% reporta beneficios tanto en costos como en ingresos, y el 56% no ha visto un beneficio significativo (PwC, 2026; Yotzov et al., 2026).
La historia de la informática ofrece un antecedente relevante y una advertencia. En 1987 Solow dice “la era de las computadoras se ve en todas partes menos en las estadísticas de productividad”; para la IA, las estimaciones de su aporte a la productividad difieren en un orden de magnitud: de 0,06 puntos porcentuales anuales durante una década (Acemoglu, 2024) a entre 0,07 y 1,24, con una mediana de 0,68 (Aghion y Bunel, 2024). Según David (1990), las tecnologías de propósito general suelen tardar entre 25 y 40 años en traducirse en efectos medibles; la inversión en computación pareció despilfarradora en los ochenta y sólo entre 1995 y 2005 se materializó en ganancias de productividad (David, 1990; Jorgenson, Ho y Stiroh, 2008). Si ese mismo patrón se repitiera con la IA, la ineficiencia actual sería transitoria, una posibilidad que el análisis institucional reciente considera plausible (Calvino, Haerle y Liu, 2025). Este argumento no invalida la preocupación por las externalidades materiales. A diferencia del caso que David analiza, donde el “despilfarro” consistía principalmente en sobreconsumo eléctrico e inversión en hardware que la industria luego optimizó (Jorgenson, Ho y Stiroh, 2008), las externalidades de la IA generativa incluyen extracción hídrica y minera cuya huella, una vez producida, no desaparece con mejoras en la eficiencia energética. Conviene reconocer, además, que la IA generativa registra aplicaciones de valor real —en investigación científica, accesibilidad, análisis de datos y otras aplicaciones productivas— que este ensayo no disputa; su foco está en las externalidades materiales que esos mismos usos acarrean.
En este contexto, los hyperscalers obtienen márgenes de 20–40%, que tanto el regulador británico Ofcom como el Open Markets Institute interpretan como indicio de extracción de rentas monopólicas (Ofcom, 2023; von Thun y Colville, 2026), aunque también podrían reflejar los altos costos de construir, mantener y expandir infraestructura física a esa escala —servidores, centros de datos, redes de fibra—.
La brecha entre inversión y productividad es algo que los propios protagonistas reconocen cuando hablan de la burbuja. Bret Taylor (OpenAI): “La IA transformará la economía y creará enormes cantidades de valor económico en el futuro. También creo que estamos en una burbuja, y mucha gente va a perder mucho dinero” (IEEE ComSoc, 2025); Sam Altman (CEO de OpenAI) y Jeff Bezos (fundador de Amazon) han advertido sobre sobreinversión (Sonnenfeld y Henriques, 2025). Si la burbuja de IA estalla, como ocurrió con las punto-com y las hipotecas subprime, es razonable esperar que los costos recaigan de manera desproporcionada sobre las comunidades que ya absorben las externalidades materiales, como ocurrió en 2008 (Ocampo, 2009; O’Neil et al., 2008).
La política de apoyos hacia la región de OpenAI, Google y Microsoft no financia la transferencia de modelos ni infraestructura soberana: Google.org destinó más de 15 millones de dólares en 2024 a organizaciones en América Latina para habilidades digitales y uso de IA (Google.org, 2025); según sus propios comunicados, las grandes plataformas ofrecen créditos de API y becas de investigación, no capacidad productiva ni infraestructura transferible. Esas iniciativas financian uso (acceso a APIs, créditos de nube, becas). El sector público latinoamericano despliega cientos de sistemas de IA —chatbots, reconocimiento facial, modelos predictivos— documentados en 26 países, pero casi todos son aplicaciones construidas sobre infraestructura cloud extranjera (Gutiérrez et al., 2026).
Los altos márgenes y la inversión especulativa permiten construir más infraestructura de la que la demanda actual justificaría, y cada centro de datos adicional consume electricidad, agua y minerales que de otra manera estarían disponibles para otros usos. Se trata, al menos en parte, de infraestructura de burbuja.
4. Palancas de gobernanza para América Latina
Si la IA generativa es infraestructura —como argumenta este artículo—, entonces se podrían aplicar las mismas herramientas: reglas, inspección, permisos y competencia real. Las palancas que siguen responden a las dependencias ya descritas. Ortiz Freuler (2025) ordena las intervenciones posibles sobre los puntos de control de la infraestructura en seis estrategias —subsidiar nuevos bordes, agregar una capa neutralizadora, romper el nodo, diversificar su gobernanza, capturarlo o regular sus operaciones—, un repertorio que la región puede aplicar a la infraestructura de IA: regulación de la infraestructura cloud y de los permisos que esta requiere (energía, agua, suelo); regulación de los datos de entrenamiento y del trabajo en la cadena de valor; alternativas técnicas que reduzcan la dependencia de modelos e infraestructura propietaria; y acción colectiva y formación como base de presión y de soberanía tecnológica. Estas palancas existen; activarlas exige decisión política, pero su efectividad depende de capacidades estatales, coordinación regional y marcos que aborden las tensiones estructurales que se detallan al final de esta sección.
4.1 Regulación de infraestructura como servicio público
Por infraestructura cloud se entienden aquí los centros de datos y los servicios de computación en la nube que ofrecen los hyperscalers, de los que dependen sectores enteros de la economía y la sociedad. Tratar esa infraestructura como servicio público esencial es la palanca más directa. Los centros de datos que se instalan en la región operan con permisos locales —de agua, de electricidad, de uso de suelo— que constituyen puntos de intervención inmediatos; exigir reportes de sostenibilidad verificados, participación comunitaria en audiencias y evaluación de impacto ambiental con umbrales que incluyan el consumo hídrico y energético sería un primer paso. Un gran obstáculo para esta palanca regulatoria es el lobby documentado de las grandes tecnológicas: una investigación coordinada por CLIP y Agência Pública registró casi 3.000 acciones de influencia y 59 casos de puerta giratoria en diez países (Peñarredonda et al., 2025).
Ese acceso diferencial a los tomadores de decisión —y la captura regulatoria que documenta Aos Fatos (2025)— ayuda a explicar por qué en varios países las autoridades han apoyado o permitido la opacidad de las empresas en lugar de exigir transparencia sobre consumo de agua, energía e impacto ambiental. El reporte ambiental de Google ilustra este patrón. Entre 2023 y 2024 el consumo de electricidad de sus centros de datos creció un 27%, pero la empresa reportó una reducción del 12% en sus emisiones de centros de datos, una reducción que responde a la contabilidad de sus contratos de energía limpia basados en certificados de energía renovable y no a una caída del consumo eléctrico, que en el mismo período creció (Google, 2025).
Los casos documentados muestran marcos que favorecen la exención. En Chile, en 2025 el Consejo de Ministros para la Sustentabilidad modificó el reglamento del Sistema de Evaluación de Impacto Ambiental (SEIA) subiendo de 80 a 1.000 toneladas el umbral de almacenamiento de combustible que obliga a evaluación ambiental; los centros de datos se evalúan por el diésel de sus generadores de respaldo, no por consumo de agua ni electricidad, y con el nuevo umbral la gran mayoría queda exenta (Skoknic y Pizarro, 2025). En Querétaro los centros en parques industriales están exentos de presentar manifestación de impacto ambiental (MIA) porque se construyen en parques aprobados previamente; además, el secretario de desarrollo sostenible del estado ha afirmado que los centros de datos no requieren MIA por considerarse “servicio” y no “industria”, y que están exentos del impuesto local sobre emisiones de gases de efecto invernadero por no ser “fuentes fijas de emisiones directas” (Baptista y McDonnell, 2025).
Frente a ese panorama, la propuesta más concreta proviene del Open Markets Institute: aplicar a los hyperscalers (Amazon Web Services, Microsoft Azure, Google Cloud) obligaciones equivalentes a las que rigen la electricidad o las telecomunicaciones (von Thun y Colville, 2026). Eso incluye precios transparentes, justos y no discriminatorios (en la jerga regulatoria, FRAND: fair, reasonable and non-discriminatory), interoperabilidad obligatoria entre proveedores, portabilidad de datos sin barreras técnicas artificiales, y reportes de sostenibilidad verificados. Existen precedentes en energía, telecomunicaciones y digital: la Unión Europea ya exige la separación estructural (unbundling) entre generación y transmisión de energía; en telecomunicaciones, el regulador británico obligó a BT a escindir Openreach, su división de infraestructura de red, en una empresa legalmente independiente. En el sector digital, la Comisión Europea obligó a Microsoft a ofrecer Windows sin el Reproductor de Medios y a publicar información de interoperabilidad para servidores; en Estados Unidos, el Departamento de Justicia ha propuesto la venta de Chrome —y en último término de Android— para restablecer competencia en búsqueda (Comisión Europea, 2004; DOJ, 2024). En América Latina existen intervenciones recientes en la misma línea, aunque hasta ahora de carácter conductual más que estructural: en México, la Comisión Nacional de Competencia obligó a Google a eliminar restricciones que ataban Android y la Play Store a los fabricantes de dispositivos, de modo que estos puedan ofrecer otros sistemas operativos y aplicaciones (Proceso, 2025); en Brasil, el CADE ha impuesto a Apple compromisos para permitir pagos de terceros en aplicaciones y ha impulsado la primera sanción de la autoridad a una gran tecnológica por prácticas anticompetitivas en mercados digitales (OECD, 2025).
Instrumentos europeos como el Digital Markets Act (DMA), el Data Act y el futuro Cloud and AI Development Act (CADA) contienen herramientas (obligaciones de interoperabilidad, portabilidad de datos) adaptables al contexto latinoamericano (von Thun y Colville, 2026). La dependencia cloud es transversal (hospitales, universidades, medios, gobiernos) y Ferrari Braun y Cath (2026) argumentan que “el momento de la intervención regulatoria es ahora”. La auditoría de la Journalism Cloud Alliance (JCA) sobre servicios cloud de medios y organizaciones de periodismo de investigación —convocada por el GFMD y OCCRP, con 24 organizaciones auditadas en 2025— refuerza el diagnóstico: la tecnología e infraestructura absorben entre 15% y 20% del presupuesto de las redacciones; los costes cloud crecen con rapidez y la migración a otro proveedor resulta costosa y difícil (Geber y Szyszlican, 2025).
La región no parte de cero en materia regulatoria. el Senado de Brasil aprobó en diciembre de 2024 el proyecto de Marco Legal de IA (PL 2338/2023), que desde 2025 espera el dictamen de una comisión especial de la Cámara de Diputados; Chile tramita una ley similar (Cooperativa, 2025); Argentina impulsa la actualización de su Ley de Protección de Datos (AAIP, 2022/2023) y tramita un proyecto que obliga a plataformas digitales extranjeras a establecer domicilio legal en el país (Castagneto, 2026). La ANPD brasileña suspendió el uso de datos de usuarios para entrenar modelos de Meta, argumentando que el “interés legítimo” no constituye base legal suficiente (Future of Privacy Forum, 2024). El DPI-AI Framework (Abadie, 2026) es una palanca concreta porque ofrece un esquema de diseño para integrar IA en la administración pública de forma interoperable y soberana (bloques de IA reutilizables, flujos de trabajo auditables, estándares abiertos) que reduce la dependencia de un único proveedor cloud o de modelos propietarios. Otra palanca es extender al resto de la región las legislaciones específicas sobre residuos electrónicos (RAEE) y los esquemas de responsabilidad extendida del productor: el monitoreo regional de la UNU/UNITAR para América Latina documenta que sólo cinco de trece países analizados —Bolivia, Chile, Costa Rica, Ecuador y Perú— cuentan con ese tipo de normas (Wagner et al., 2022).
Contrarrestar la captura es un proyecto complejo; generalizar registros obligatorios de actividad de lobby y períodos de enfriamiento para altos cargos y reguladores sería un primer paso para que la decisión política no quede capturada por la industria. La Recomendación de la OCDE sobre transparencia e integridad en el lobby (OECD, 2024) y las normas de la UE sobre puerta giratoria (EPRS, 2024) ofrecen estándares de referencia; Chile tiene registro público de lobby, que permitió documentar reuniones entre tecnológicas y funcionarios (Medina et al., 2025); Argentina tramita una ley de lobby con registro obligatorio y una inhabilitación de 24 meses para ex funcionarios (Poder Ejecutivo Nacional, 2026), aunque Human Rights Watch (2026) advierte que, tal como está redactada, permitiría al Ejecutivo excluir a las organizaciones de la sociedad civil del debate público. En la Unión Europea los exdiputados tienen un período de enfriamiento de seis meses; pasado este, quienes ejerzan lobby deben inscribirse en el Registro de Transparencia (EPRS, 2024). Ninguna de estas medidas basta: su alcance depende de la aplicación efectiva y las sanciones por incumplimiento.
Estas palancas no son de aplicación trivial, y conviene reconocer sus tensiones. Tratar la infraestructura cloud como servicio público supone que los reguladores latinoamericanos cuenten con la capacidad técnica para auditar a los hyperscalers y fiscalizar su consumo de agua y energía, una capacidad que, como muestran los casos documentados anteriormente, hoy es desigual: las autoridades carecieron de datos públicos para actuar. La regulación más estricta entra además en tensión con la competencia por atraer inversión: el mismo régimen de incentivos que volvió atractiva a la Patagonia argentina para el centro de datos de OpenAI —el RIGI— ilustra que los Estados de la región compiten ofreciendo beneficios fiscales y laxitud ambiental, de modo que una jurisdicción que endurezca sus exigencias puede ver desplazada la inversión hacia la vecina. Algunas propuestas de mayor alcance, como regular los datos de entrenamiento o el entrenamiento mismo de los modelos, chocan con la dificultad de fiscalizar procesos que ocurren fuera del territorio y con el riesgo de penalizar también a los proyectos abiertos y públicos que la región busca impulsar. Estas tensiones no invalidan las palancas pero condicionan su alcance: la efectividad de estas medidas depende de coordinación regional, de inversión en capacidades estatales de fiscalización y de marcos que distingan entre los grandes operadores y las alternativas públicas o comunitarias.
4.2 Regulación de datos de entrenamiento y trabajo
Frente a la asimetría en los datos de entrenamiento y a las condiciones del trabajo en la cadena de valor de la IA, los Estados aún tienen margen para intervenir en dos frentes: el uso de acervos y obras, y los derechos de quienes producen o anotan datos. Según estimaciones basadas en Common Crawl, el español y el portugués representan apenas cerca del 4% y el 2% de los datos con que se entrenan los grandes modelos de lenguaje (CENIA, 2026).
Hay una enorme cantidad de conocimiento que no está en internet (tradiciones orales, acervos no digitalizados, saberes comunitarios) y que, por tanto, no está en los modelos. El dilema de digitalizar, exponiéndose a la extracción corporativa, o no publicar, limitando visibilidad y representatividad, se podría resolver con marcos legales que distingan acceso público de explotación comercial; aunque también existen acuerdos de acceso condicionado que, como muestra LatamGPT, no garantizan soberanía si la infraestructura sigue siendo extranjera. Las licencias de acervos digitales podrían excluir explícitamente la extracción para modelos de lenguaje. En la práctica, el licenciamiento ha sido irrelevante para cómo se construyeron los corpus de los modelos más grandes: documentos judiciales desclasificados revelan que Meta obtuvo autorización de su director ejecutivo para descargar y usar Library Genesis (LibGen), una de las mayores bibliotecas pirata en línea (más de 7,5 millones de libros y 81 millones de artículos), creada para dar acceso a personas en África, India, Rusia y otros territorios sin acceso académico; empleados de Meta reconocieron un “riesgo legal medio-alto” y discutieron mitigaciones como eliminar líneas con ISBN o “Copyright” (Reisner, 2025). OpenAI también utilizó LibGen en el pasado (Reisner, 2025). Por otra vía, Anthropic impulsó en 2024 el “Proyecto Panamá”, descrito en documentos internos como “nuestro esfuerzo por escanear de forma destructiva todos los libros del mundo”; la empresa buscaba comprar libros físicos, escanearlos —método que suele implicar cortar el lomo con guillotina para aplanar páginas— y deshacerse de los restos, y pedía mantener el proyecto en secreto (Schaffer et al., 2026). Las licencias y la exclusión de extracción en acervos digitales siguen siendo palancas útiles para bibliotecas y Estados, pero estas prácticas muestran que varias de las empresas de IA más grandes han eludido el licenciamiento cuando les convino.
La trazabilidad de datasets y los límites al uso no consentido de obras podrían abordarse desde la contratación pública: los pliegos de servicios de IA pueden incluir cláusulas que prohíban el uso de datos institucionales para entrenamiento, o el uso de modelos que hayan utilizado datos de entrenamiento no consentidos — modelo que la Comisión Europea ya implementó en sus cláusulas contractuales modelo para IA (Comisión Europea, 2025).
La regulación de las condiciones de trabajo en la cadena de valor de la IA es una deuda pendiente. En febrero de 2024, representantes de microworkers convocados por la iniciativa EnCOre presentaron sus demandas ante el Cuarto Foro Transnacional sobre Alternativas a la Uberización en el Parlamento Europeo: reconocimiento como trabajadores de plataforma bajo la Directiva europea correspondiente, fin de la retención arbitraria de pagos y acceso a acompañamiento en salud mental (Miceli et al., 2024). El establecimiento de mecanismos equivalentes —compensación, protección laboral, acceso a salud mental— para anotadores de datos en la región es una intervención que los Estados latinoamericanos pueden implementar sin esperar consensos globales.
4.3 Alternativas técnicas: modelos abiertos y privacidad
Frente a la dependencia de modelos e infraestructura propietaria, existen alternativas técnicas que reducen el cerrojo corporativo. Modelos como OLMo 3 y StarCoder2 publican pesos, código y datos bajo licencia abierta (Allen Institute for AI, 2025; BigCode Project, 2024). La Open Source Initiative (OSI) fija un estándar exigente, según el cual un sistema solo es abierto si puede usarse, estudiarse, modificarse y compartirse, lo que obliga a publicar también el código de entrenamiento y la información sobre los datos empleados, aunque no los datos en sí, una limitación que la propia OSI reconoce (Open Source Initiative, 2024). La mayoría de lo que la industria llama “abierto” —incluido Llama, de Meta— libera únicamente los pesos del modelo, lo que permite ejecutarlo en infraestructura propia, compartida, comunitaria o soberana pero no conocer con qué datos fue entrenado ni reproducir el proceso. Son modelos semiabiertos. Aun así, un modelo semi-abierto reduce la exposición de los datos de los usuarios a plataformas propietarias y permite que comunidades técnicas auditen sus sesgos, de modo que para una institución pública representa una mejora sustancial respecto de los sistemas cerrados. Además, la brecha de capacidades entre modelos abiertos y propietarios se está cerrando: un memo filtrado de Google admitió en 2023 que “no tenemos foso” frente al código abierto (Patel y Ahmad, 2023).
La destilación, técnica por la cual un modelo más pequeño aprende replicando las respuestas de uno más grande, logrando rendimiento comparable a una fracción del costo, acelera ese proceso. Las grandes empresas la persiguen no por vía del derecho de autor, cuya aplicación es incierta, sino mediante cláusulas contractuales en sus términos de servicio que prohíben usar sus outputs para entrenar modelos competidores (Chen, 2025). Comunidades de infraestructura autónoma de la región ya desarrollan estrategias activas frente a este extractivismo de datos —bloqueo de crawlers por número de red, envenenamiento de modelos, herramientas de detección—, documentando que la resistencia técnica es posible sin depender de grandes proveedores (Sutty, 2026).
En América Latina, el proyecto más ambicioso es LatamGPT: un modelo de 70 mil millones de parámetros coordinado por el Centro Nacional de Inteligencia Artificial de Chile (CENIA) con más de 60 instituciones de 15 países, entrenado sobre más de 300 mil millones de tokens de texto en español, portugués y lenguas indígenas como quechua, guaraní y mapudungun (CENIA, 2026; Levy Yeyati, 2025). Su diseño federado permite ajustes por país, y sus fuentes incluyen decisiones judiciales de Buenos Aires, registros de bibliotecas de Perú y textos escolares de Colombia. Sin embargo, LatamGPT también ilustra los límites de la soberanía técnica sin soberanía infraestructural: el modelo se construye sobre Llama 3.1 de Meta y se entrenó en servidores de AWS ubicados en Virginia, donde los datos —decisiones judiciales, registros de bibliotecas y textos escolares de países latinoamericanos— quedaron bajo una jurisdicción que permite al gobierno de EE.UU. acceder a ellos sin notificar a los afectados (FISA §702; Hildén, 2021). La alternativa regional más ambiciosa sigue dependiendo de la infraestructura que busca reemplazar.
Proyectos como MapleAI y Confer demuestran IA sin ceder datos a corporaciones (MapleAI, 2025; Marlinspike, 2025); en el mismo eje de privacidad en la inferencia, Apple ha desplegado Private Cloud Compute para Apple Intelligence —una nube propia donde la empresa se compromete a no acceder ni retener los datos del usuario y a no usarlos para entrenar modelos— (Apple, 2024), aunque dentro de su ecosistema cerrado. Incluir requisitos de privacidad verificable y de modelos abiertos en las compras públicas reduciría la dependencia de proveedores que retienen datos y modelos bajo llave.
4.4 Acción colectiva y formación
Frente a la concentración de poder en pocas empresas, la organización colectiva y la formación de capacidades locales operan como palancas de presión y de soberanía tecnológica. La resistencia individual al extractivismo digital —comprar con más cuidado, usar herramientas alternativas— es necesaria pero insuficiente; lo que funciona es la organización colectiva y la exigencia de transparencia y participación en las decisiones que afectan a los territorios. O como dice Cory Doctorow (2025): “Las acciones individuales no provocan cambio sistémico.”
En América Latina, esa organización ya existe. El activismo local y territorial ha obtenido en varios países resultados concretos: mayor transparencia sobre consumo de agua y energía, participación en audiencias y en algunos casos fallos que obligan a las empresas a dar información o a someterse a revisión ambiental. En Uruguay, la presión del Movimiento por un Uruguay Sustentable (MOVUS) y de Amigos de la Tierra Uruguay logró que Google modificase el proyecto de su centro de datos en Canelones: el diseño original contemplaba enfriar los servidores con millones de litros de agua potable, lo que generó rechazo en un país que sufría en 2023 su peor sequía desde 1950, que dejó sin agua potable a la capital; la movilización derivó en el reemplazo del enfriamiento evaporativo por aire acondicionado antes de que las autoridades aprobaran el proyecto (Livingstone, 2024); en Uruguay, donde más del 90% de la electricidad proviene de fuentes renovables, ese trade-off pesa menos que en una matriz fósil, aunque el proyecto igual suma emisiones. En Chile, la plataforma pública del SEIA permitió durante años a vecinos y organizaciones hacer seguimiento y reclamos; en 2024 un tribunal ambiental revocó parcialmente la calificación favorable del proyecto de Google en Cerrillos, y activistas como los de Quilicura han usado esa transparencia para exigir rendición de cuentas (Skoknic y Pizarro, 2025). En Brasil y México, comunidades y organizaciones como Voceras de la Madre Tierra en Querétaro exigen regulación, transparencia hídrica y que los centros de datos no eludan las evaluaciones de impacto; en México esa resistencia ha llevado a foros universitarios y también a la discusión pública sobre proyectos de ley de agua (Baptista y McDonnell, 2025; Baptista y McDonnell, 2026; Medina et al., 2025).
Ese activismo tiene costos concretos. En Querétaro, activistas de las Voceras de la Madre Tierra han sido criminalizados, detenidos arbitrariamente y torturados bajo falsas acusaciones; en 2023, once manifestantes fueron detenidos durante una protesta y un joven quedó al borde de la parálisis (Ricaurte y Roldán, 2025). El Acuerdo de Escazú —ratificado por diecinueve países de la región— garantiza a los defensores del medio ambiente el derecho a participar en decisiones ambientales y protección frente a represalias; su aplicación efectiva es una condición necesaria para que las palancas de participación comunitaria sean practicables.
Más allá del activismo ambiental, otras redes trabajan en tecnología cívica, documentación y soberanía de datos. Comunidades como #Bandatos en Ciudad de México (Bandatos, 2025) trabajan en las aplicaciones de la inteligencia artificial a proyectos de tecnología cívica. LAIA (Laboratorio Abierto de Inteligencia Artificial) explora los impactos de la IA de forma interdisciplinaria y propone iniciativas en desarrollo como el Índice Black Box (para medir la dependencia de organizaciones respecto de sistemas cerrados) y una IA personal segura basada en modelos abiertos y privacidad (LAIA, 2025). DataCenter Boom documenta conflictos socioambientales y ofrece herramientas para la participación comunitaria en audiencias públicas. Metodologías de gobernanza comunitaria probadas en la región —por ejemplo, pilotos de participación que priorizan la reconstrucción de confianza y la activación progresiva desde intereses ciudadanos reales (Ciudadanía Inteligente, 2026)— pueden informar cómo llevar a cabo esos procesos de forma legítima. La Eticas Foundation ha documentado una metodología de auditorías algorítmicas lideradas por comunidades que coloca a las personas afectadas en el centro de la rendición de cuentas de sistemas de IA (identificación participativa del sistema, análisis contextual, recolección de datos con la comunidad y análisis para incidencia) y constituye un referente replicable (Eticas Foundation, 2024).
En el plano de datos y transparencia, Amnesia.lat resguarda información pública que los gobiernos intentan borrar, distribuyéndola a través de la plataforma Mozilla Data Collective bajo licencias abiertas; esos datos preservados, además de garantizar rendición de cuentas, pueden alimentar modelos de la región con fuentes éticas y verificables. Una auditoría reciente de dependencia cloud en medios de comunicación globales (Geber y Szyszlican, 2025) mostró que la metodología es replicable: cualquier institución pública puede evaluar su propia dependencia de infraestructura extranjera con herramientas abiertas. Organizaciones de defensa de derechos humanos en la región han documentado necesidades concretas de infraestructura soberana, formación en comunicación digital y herramientas culturalmente apropiadas; la mayoría percibe sus problemas pero desconoce las soluciones disponibles (Sutty, 2024).
La formación es una palanca adicional. Si la industria deja de contratar profesionales junior, la base de formación para los expertos de la próxima generación se estrecha. En 2025, el empleo de desarrolladores de software de entre 22 y 25 años en Estados Unidos cayó cerca de un 20% en los sectores donde las ganancias de productividad de la IA son más medibles, mientras el empleo de desarrolladores mayores siguió creciendo (Stanford HAI, 2026). La reducción del empleo junior en tecnología abre una brecha de formación; cerrarla requiere que las instituciones educativas y las comunidades técnicas de la región asuman un rol aún más activo en la transmisión de capacidades locales.
5. Conclusiones
Este ensayo propuso entender la IA generativa como una industria con dependencias materiales concretas, antes que como el fenómeno tecnológico autónomo que postula el relato dominante. Energía, agua, semiconductores y trabajo humano son las condiciones materiales de funcionamiento de esa industria, los puntos en los que requiere permisos, contratos y recursos que alguna autoridad debe autorizar; tratarlos como meros efectos secundarios del progreso técnico oscurece precisamente su carácter gobernable.
Cada una de esas dependencias constituye, por ello, un punto de intervención regulatoria. El suministro eléctrico de un centro de datos depende de contratos con distribuidoras sujetas a regulación estatal; el agua de enfriamiento, de permisos municipales; los semiconductores, de regímenes aduaneros; y la anotación de datos, de marcos laborales que en buena parte de la región todavía no la amparan. Ninguno de estos eslabones es inmaterial ni queda fuera del alcance de la regulación; su activación depende de una decisión política que no quede capturada por la industria.
América Latina no fabrica chips ni opera hyperscalers, pero controla los permisos locales —de agua, energía y uso de suelo— que hacen posible la operación de esa infraestructura en su territorio. Ese control habilita exigencias concretas, como reportes de consumo verificados, participación comunitaria en audiencias públicas, condiciones laborales dignas en la cadena de valor y marcos que regulen la infraestructura cloud como el servicio público esencial en que se ha convertido para sectores enteros de la economía y la sociedad. Esa participación, sin embargo, no es gratuita: los casos documentados muestran que quienes la ejercen enfrentan criminalización y represalias. La ratificación y aplicación efectiva del Acuerdo de Escazú es, en ese sentido, una condición de posibilidad para las demás palancas.
La burbuja de inversión agrava estas externalidades y, al mismo tiempo, las hace visibles. Cuando Bezos llama al entorno “una burbuja industrial” y Altman advierte que “la gente sobreinvertirá y perderá dinero” (Sonnenfeld y Henriques, 2025), reconocen que la demanda actual no justifica la escala de inversión. Si la apuesta se corrige, como ocurrió con las punto-com y las hipotecas subprime, es probable que sus costos recaigan de manera desproporcionada sobre las comunidades que ya absorben las externalidades. La discusión pertinente se desplaza así de la permanencia de la IA hacia las reglas bajo las que opera y los actores que las definen. La distancia entre el discurso corporativo de la desmaterialización y las condiciones materiales de quienes sostienen la industria es, en última instancia, el principal argumento a favor de la intervención regulatoria.
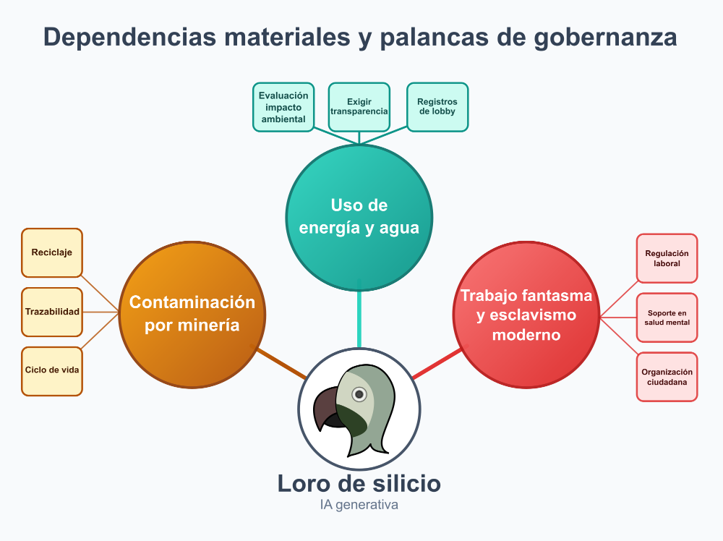
Figura 1. Dependencias materiales de la IA generativa y palancas de gobernanza (energía y agua, minerales, trabajo humano)
Referencias
AAIP. (2022/2023). Proyecto de Ley de Protección de Datos Personales. Agencia de Acceso a la Información Pública, Argentina. https://www.argentina.gob.ar/aaip/datospersonales/proyecto-ley-datos-personales
Abadie, D. (2026). DPI-AI framework: Building AI-ready nations through digital public infrastructure. Centre for Digital Public Infrastructure. https://digitalpublicinfrastructure.ai/wp-content/uploads/2026/01/Vision_Paper_-DPI-AI-Framework_2026_CDPI.pdf
Acemoglu, D. (2024). The simple macroeconomics of AI (NBER Working Paper No. 32487). National Bureau of Economic Research. https://www.nber.org/papers/w32487
Aghion, P. y Bunel, S. (2024, junio). AI and growth: Where do we stand? https://www.frbsf.org/wp-content/uploads/AI-and-Growth-Aghion-Bunel.pdf
Alcott, B. (2005). Jevons’ paradox. Ecological Economics, 54(1), 9–21. https://doi.org/10.1016/j.ecolecon.2005.03.020
Allen Institute for AI. (2025). OLMo 3: Charting a path through the model flow to lead open-source AI. https://allenai.org/blog/olmo3
Aos Fatos. (2025, 9 de diciembre). El lobby de las big techs hace promesas irreales al estimular la carrera por los data centers en América Latina. Por Luiz Fernando Menezes. Aos Fatos. https://www.aosfatos.org/noticias/lobby-big-techs-promesas-irreales-estimular-carrera-data-centers-america-latina/
Apple. (2024). Private Cloud Compute: A new frontier for AI privacy in the cloud. Apple Security Research. https://security.apple.com/blog/private-cloud-compute/
Bain & Company. (2026, 29 de septiembre). New innovation is required to fund AI’s $6 trillion buildout. Technology Report 2026. https://www.bain.com/insights/new-innovation-is-required-to-fund-ais-6-trillion-buildout-technology-report-2026/
Bandatos. (2025). Tecnología cívica e inteligencia artificial. Bandatos. https://bandatos.org
Baptista, D. y McDonnell, F. (2024, 6 de septiembre). Thirsty data centres spring up in water-poor Mexican town. Context News. https://www.context.news/ai/thirsty-data-centres-spring-up-in-water-poor-mexican-town
Baptista, D. y McDonnell, F. (2025, 14 de octubre). Data centres lured to Mexico can avoid environmental reporting. Context News. https://www.context.news/ai/data-centres-lured-to-mexico-can-avoid-environmental-reporting
Baptista, D. y McDonnell, F. (2026, 4 de febrero). Resistance blooms in Mexico’s data centre valley. Context News. https://www.context.news/ai/long-read/resistance-blooms-in-mexicos-data-centre-valley
Barringer, F. (2025, 8 de abril). Thirsty for power and water: AI-crunching data centers sprout across the West. & the West, Stanford University. https://andthewest.stanford.edu/2025/thirsty-for-power-and-water-ai-crunching-data-centers-sprout-across-the-west/
Bender, E. M., Gebru, T., McMillan-Major, A. y Shmitchell, S. (2021). On the dangers of stochastic parrots: Can language models be too big? En Proceedings of the 2021 ACM Conference on Fairness, Accountability, and Transparency (FAccT ’21) (pp. 610–623). ACM. https://dl.acm.org/doi/10.1145/3442188.3445922
BigCode Project. (2024). StarCoder 2 and The Stack v2: The next generation. https://github.com/bigcode-project/starcoder2
Borges, T. y Branford, S. (2020, 11 de junio). MRN bauxite mine leaves legacy of pollution, poverty in Brazilian Amazon. Mongabay. https://news.mongabay.com/2020/06/mrn-bauxite-mine-leaves-legacy-of-pollution-poverty-in-brazilian-amazon/
Bratton, B. H. (2016). The Stack: On Software and Sovereignty. MIT Press. https://mitpress.mit.edu/9780262029575/the-stack/
Cacciuttolo, C. y Cano, D. (2022). Environmental impact assessment of mine tailings spill considering metallurgical processes of gold and copper mining: Case studies in the Andean countries of Chile and Peru. Water, 14(19), 3057. https://doi.org/10.3390/w14193057
Calvino, F., Haerle, D. y Liu, S. (2025). Is generative AI a General Purpose Technology? Implications for productivity and policy. OECD Artificial Intelligence Papers, No. 40. https://doi.org/10.1787/704e2d12-en
Castagneto, C. D. (2026, 31 de marzo). Proyecto de Ley: Responsabilidad de las plataformas digitales extranjeras (en comisión). Honorable Cámara de Diputados de la Nación Argentina. https://rest.hcdn.gob.ar/web/proyectos/290487/adjuntos/104934
CENIA. (2026, 10 de febrero). Latam-GPT: la primera IA regional abierta creada con datos latinoamericanos. Centro Nacional de Inteligencia Artificial. https://cenia.cl/2026/02/10/latam-gpt-la-primera-ia-regional-abierta-creada-con-datos-latinoamericanos/
Challapally, A., Pease, C., Raskar, R. y Chari, P. (2025). State of AI in business 2025. MIT NANDA. https://mlq.ai/media/quarterly_decks/v0.1_State_of_AI_in_Business_2025_Report.pdf
Chen, Y. (2025, 23 de julio). The legal controversy around AI knowledge distillation: A balanced perspective. Laboratoire de cyberjustice, Université de Montréal. https://www.cyberjustice.ca/2025/07/23/the-legal-controversy-around-ai-knowledge-distillation-a-balanced-perspective/
Ciudadanía Inteligente. (2026). Pilotos de gobernanza comunitaria: Reconstruir confianza para fortalecer la democracia ambiental local en Peñalolén. [Santiago, Chile]. https://gitlab.com/ciudadaniai/2022/-/raw/main/cuadernillo-gobernanza-comunitaria.pdf
Cockerell, I. (2025, 31 de marzo). In Kenya’s slums, they’re doing our digital dirty work. Coda Story. https://www.codastory.com/authoritarian-tech/the-hidden-workers-who-train-ai-from-kenyas-slums/
Comisión Europea. (2004). Decisión de la Comisión, de 24 de marzo de 2004, relativa a un procedimiento de aplicación del artículo 82 del Tratado CE (asunto COMP/C-3/37.792 — Microsoft). DO L 134 de 30.4.2007. https://ec.europa.eu/competition/antitrust/cases/dec_docs/37792/37792_4177_1.pdf
Comisión Europea. (2025). Updated EU AI model contractual clauses. Public Buyers Community. https://public-buyers-community.ec.europa.eu/communities/procurement-ai/resources/updated-eu-ai-model-contractual-clauses
Conagua-SMN. (2024, 15 de junio). Monitor de Sequía de México. Comisión Nacional del Agua y Servicio Meteorológico Nacional. https://smn.conagua.gob.mx/tools/DATA/Climatolog%C3%ADa/Sequ%C3%ADa/Monitor%20de%20sequ%C3%ADa%20en%20M%C3%A9xico/Seguimiento%20de%20Sequ%C3%ADa/MSM20240615.pdf
Cooperativa. (2025, 13 de octubre). Diputados aprobaron proyecto para regular la inteligencia artificial en Chile. Cooperativa.cl. https://www.cooperativa.cl/noticias/pais/politica/camara-baja/diputados-aprobaron-proyecto-para-regular-la-inteligencia-artificial-en-chile/2025-10-13/213644.html
Cottier, B., Rahman, R., Fattorini, L., Maslej, N., Besiroglu, T. y Owen, D. (2024). The rising costs of training frontier AI models. arXiv. https://arxiv.org/abs/2405.21015
Crawford, K. (2022). Atlas de inteligencia artificial: poder, política y costos planetarios (F. Díaz Klaassen, Trad.). Fondo de Cultura Económica. (Obra original publicada en 2021).
DataCenter Boom. (2026, 5 de febrero). Los data centers y la energía en Chile: Demanda, infraestructura y posible impacto en precios de electricidad [Informe de M. Neto]. Instituto Latinoamericano de Terraformación. https://datacenterboom.net/wp-content/uploads/2026/02/Los-data-centers-y-la-energia-en-Chile_demanda-infraestructura-y-posible-impacto-en-precios-de-electricidad.pdf
DataCenter Dynamics. (2025, 11 de junio). Sam Altman: ChatGPT queries consume 0.34 watt-hours of electricity and 0.000085 gallons of water. https://www.datacenterdynamics.com/en/news/sam-altman-chatgpt-queries-consume-034-watt-hours-of-electricity-and-0000085-gallons-of-water/
David, P. A. (1990). The dynamo and the computer: An historical perspective on the modern productivity paradox. American Economic Review, 80(2), 355–361. https://www.jstor.org/stable/2006600
De Vries-Gao, A. (2025). The carbon and water footprints of data centers and what this could mean for artificial intelligence. Patterns. https://doi.org/10.1016/j.patter.2025.101430
Doctorow, C. (2025, 13 de septiembre). Consumption choices. Pluralistic. https://pluralistic.net/2025/09/13/consumption-choices/
DOJ. (2024, 20 de noviembre). Google must sell Chrome to restore competition in online search, DOJ argues. Reuters. https://www.reuters.com/technology/google-prosecutors-propose-cure-search-monopoly-2024-11-20/
EESI. (2025). Data centers and water consumption. Environmental and Energy Study Institute. https://www.eesi.org/articles/view/data-centers-and-water-consumption
EPRS. (2024). Rules on ‘revolving doors’ in the EU. European Parliamentary Research Service. https://www.europarl.europa.eu/thinktank/en/document/EPRS_IDA(2024)762290
Eticas Foundation. (2024). Community-led AI audits. https://eticasfoundation.org/community-led-ai-audits-methodology-for-placing-communities-at-the-center-of-ai-accountability/
Ferrari Braun, A. y Cath, C. (2026). Clouded judgements: Problematizing cloud infrastructures for news media companies. En D. Kaye (Ed.), Handbook of media regulation. Edward Elgar. https://doi.org/10.1080/10630732.2025.2546784
Fuentes Anaya, O. V. (2024). Life of a Latin American data worker [Video animado y testimonio ante el Parlamento Europeo]. Data Workers’ Inquiry. https://data-workers.org/oskarina/
Future of Privacy Forum. (2024). Processing of personal data for AI training in Brazil: Takeaways from ANPD’s preliminary decisions in the Meta case. https://fpf.org/blog/processing-of-personal-data-for-ai-training-in-brazil-takeaways-from-anpds-preliminary-decisions-in-the-meta-case/
Geber, T. y Szyszlican, M. (2025). The cloud initiative: JCA tech and cloud services audit report. Journalism Cloud Alliance / GFMD. https://gfmd.info/cloud-alliance/
Goedecke, S. (2024). Talking to ChatGPT costs 5ml of water, not 500ml. https://www.seangoedecke.com/water-impact-of-ai/
Google. (2025). Google 2025 Environmental Report. Alphabet. https://www.gstatic.com/gumdrop/sustainability/google-2025-environmental-report.pdf
Google.org. (2025, 8 de septiembre). A look at the ongoing impact of Google.org’s projects in Latin America. The Keyword. https://blog.google/company-news/outreach-and-initiatives/google-org/a-look-at-the-ongoing-impact-of-googleorgs-projects-in-latin-america/
Gray, M. L. y Suri, S. (2019). Ghost work: How to stop Silicon Valley from building a new global underclass. Houghton Mifflin Harcourt. https://ghostwork.info/
The Guardian. (2026, 26 de mayo). What you see here is a wetland without water: how the datacentre boom is exacerbating Chile’s mega-drought. The Guardian. https://www.theguardian.com/global-development/2026/may/26/chile-datacentres-water-tech-companies-mega-drought
Gutiérrez, J. D., Castellanos-Sánchez, M., Muñoz-Cadena, S. y Peralta, D. S. (2026). Sistemas de inteligencia artificial en el sector público de América Latina y el Caribe (V3.1) [Data set]. Universidad de los Andes. https://algoritmos.uniandes.edu.co/sistemas-de-ia-en-america-latina/
Hildén, J. (2021). Mitigating the risk of US surveillance for public sector services in the cloud. Internet Policy Review, 10(3). https://doi.org/10.14763/2021.3.1578
Human Rights Watch. (2026, 22 de junio). Argentina debe corregir la propuesta de ley sobre lobby. https://www.hrw.org/es/news/2026/06/22/argentina-debe-corregir-la-propuesta-de-ley-sobre-lobby
IEA. (2024). Global critical minerals outlook 2024. International Energy Agency. https://www.iea.org/reports/global-critical-minerals-outlook-2024
IEA. (2025). Global critical minerals outlook 2025. International Energy Agency. https://www.iea.org/reports/global-critical-minerals-outlook-2025
IEEE ComSoc. (2025, 1 de diciembre). AI infrastructure spending boom: A path towards AGI or speculative bubble? IEEE ComSoc Technology Blog. https://techblog.comsoc.org/2025/12/01/ai-infrastructure-spending-boom-a-path-towards-agi-or-speculative-bubble/
ITU y UNITAR. (2024). The global e-waste monitor 2024. https://ewastemonitor.info/the-global-e-waste-monitor-2024/
Jegham, N., Abdelatti, M., Elmoubarki, L., Koh, C. Y. y Hendawi, A. (2025). How hungry is AI? Benchmarking energy, water, and carbon footprint of LLM inference. arXiv. https://arxiv.org/abs/2505.09598
Jorgenson, D. W., Ho, M. S. y Stiroh, K. J. (2008). A retrospective look at the U.S. productivity growth resurgence. Journal of Economic Perspectives, 22(1), 3–24. https://doi.org/10.1257/jep.22.1.3
Jung, J. y Katz, R. (2025). Impacto económico de la inteligencia artificial en América Latina (LC/TS.2025/37/Rev.2). CEPAL. https://www.cepal.org/es/publicaciones/81909-impacto-economico-la-inteligencia-artificial-america-latina-transformacion
Kuzma, S., Bierkens, M. F. P., Lakshman, S., Luo, T., Saccoccia, L., Sutanudjaja, E. H. y Van Beek, R. (2023). Aqueduct 4.0: Updated decision-relevant global water risk indicators [Nota técnica]. World Resources Institute. https://doi.org/10.46830/writn.23.00061
LAIA. (2025). Democratizar la IA: El Plan de Laia para que nadie conquiste el mundo. https://laia.ar/wp-content/uploads/2025/05/LaiaFuturos-Reporte-final.pdf
Leite, M. G. P. y Gonçalves-Fujaco, M. A. (2013). A atividade de beneficiamento de quartzitos na cidade de Ouro Preto-Brasil: características gerais e principais impactos ambientais. Economía, sociedad y territorio, 13(41), 197-230. http://www.scielo.org.mx/scielo.php?pid=S1405-84212013000100008
León XIV. (2026, 15 de mayo). Magnifica Humanitas [Carta encíclica]. Santa Sede. https://www.vatican.va/content/leo-xiv/es/encyclicals/documents/20260515-magnifica-humanitas.html
Levy Yeyati, E. (2025, 25 de noviembre). Latam-GPT and the search for AI sovereignty. Brookings Institution. https://www.brookings.edu/articles/latam-gpt-and-the-search-for-ai-sovereignty/
Li, P., Yang, J., Islam, M. A. y Ren, S. (2023). Making AI less “thirsty”. arXiv. https://arxiv.org/abs/2304.03271
Livingstone, G. (2024, 1 de agosto). Anger mounts over environmental cost of Google datacentre in Uruguay. The Guardian. https://www.theguardian.com/global-development/article/2024/aug/01/uruguay-anger-environmental-cost-google-datacentre-carbon-emissions-toxic-waste-water
Ludvigsen, K. G. A. (2023, 18 de julio). The carbon footprint of GPT-4. Towards Data Science. https://towardsdatascience.com/the-carbon-footprint-of-gpt-4-d6c676eb21ae
MapleAI. (2025). MapleAI: Private AI with verifiable privacy. https://trymaple.ai/
Marlinspike, M. (2025). Signal founder Moxie Marlinspike on Confer and AI privacy. Time. https://time.com/7346534/signal-confer-ai-moxie-marlinspike/
McCarthy, J., Minsky, M. L., Rochester, N. y Shannon, C. E. (1955). A proposal for the Dartmouth summer research project on artificial intelligence. Dartmouth College. https://jmc.stanford.edu/articles/dartmouth/dartmouth.pdf
Medina, P., Skoknic, F., Pradilla, A., Hendrix, J., Scofield, L. y Gavarrete, J. (2025). ¿Agua y electricidad para los centros de datos o para los latinoamericanos? CLIP / La mano invisible de las Big Tech. https://www.elclip.org/agua-y-electricidad-para-los-centros-de-datos-o-para-los-latinoamericanos/
Menlo Ventures. (2026, 16 de septiembre). 2026: The state of consumer AI. https://menlovc.com/perspective/2026-the-state-of-consumer-ai/
Miceli, M. (2023). Data work and its layers of (in)visibility. Just Tech, SSRC. https://just-tech.ssrc.org/articles/data-work-and-its-layers-of-invisibility/
Miceli, M., Tubaro, P., Casilli, A. A., Le Bonniec, T., Salim Wagner, C. y Sachenbacher, L. (2024). Who trains the data for European artificial intelligence? Report of the European Microworkers Communication and Outreach Initiative (EnCOre, 2023–2024). DiPLab / Weizenbaum Institute / DAIR Institute. https://left.eu/app/uploads/2024/04/Report_EnCOre-final.pdf
Muro, V. (2021, 20 de mayo). Atlas de la inteligencia artificial: Kate Crawford y el libro que busca redefinir el alcance de los algoritmos. La Nación. https://www.lanacion.com.ar/tecnologia/atlas-de-la-inteligencia-artificial-kate-crawford-y-el-libro-que-busca-redefinir-el-alcance-de-los-nid20052021/
Ocampo, J. A. (2009). The impact of the global financial crisis on Latin America. CEPAL Review, 97, 9–32. https://hdl.handle.net/11362/11316
OECD. (2024). Recommendation of the Council on Transparency and Integrity in Lobbying and Influence (revised). OECD/LEGAL/0379. https://legalinstruments.oecd.org/public/doc/256/256.en.pdf
OECD. (2025). Remedies in digital markets in Latin America and the Caribbean. OECD Competition Committee. https://www.oecd.org/content/dam/oecd/en/publications/reports/2025/08/remedies-in-digital-markets-in-latin-america-and-the-caribbean_17c0f440/34bbc7e4-en.pdf
Ofcom. (2023). Cloud services market study: Final report. https://www.ofcom.org.uk/
O’Neil, S. K., Sweig, J., Chaskel, S. y Bustamante, M. (2008, 20 de noviembre). Latin America and the financial crisis. Council on Foreign Relations. https://www.cfr.org/blog/latin-america-and-financial-crisis
Open Source Initiative. (2024). The Open Source AI Definition (1.0). https://opensource.org/ai/open-source-ai-definition
OpenAI. (2025, 14 de octubre). Argentina’s AI opportunity. https://openai.com/global-affairs/argentinas-ai-opportunity
Ortiz Freuler, J. (2025). Infrastructural power: State strategies for internet control. Internet Policy Review, 14(2). https://doi.org/10.14763/2025.2.2009
Patel, D. y Ahmad, A. (2023, 4 de mayo). Google “We have no moat, and neither does OpenAI”. SemiAnalysis. https://newsletter.semianalysis.com/p/google-we-have-no-moat-and-neither-does-openai
Patel, D., Nishball, D. y Ontiveros, J. E. (2024, 13 de marzo). AI Datacenter Energy Dilemma – Race for AI Datacenter Space. SemiAnalysis. https://newsletter.semianalysis.com/p/ai-datacenter-energy-dilemma-race
Peñarredonda, J. L., Ronderos, M. T., Scofield, L., Rincón, A., Buitrago, E., Skoknic, F., Almeida, M. y Mena, P. (2025). Así presiona la “mano invisible” de las gigantes tecnológicas a las autoridades latinoamericanas. CLIP / La mano invisible de las Big Tech. https://www.elclip.org/asi-presiona-la-mano-invisible-de-las-gigantes-tecnologicas-a-las-autoridades-latinoamericanas/
Pigou, A. C. (1920). The Economics of Welfare. Macmillan. https://www.econlib.org/library/NPDBooks/Pigou/pgEW.html
Plantin, J.-C., Lagoze, C., Edwards, P. N. y Sandvig, C. (2018). Infrastructure studies meet platform studies in the age of Google and Facebook. New Media & Society, 20(1), 293–310. https://doi.org/10.1177/1461444816661553
Poder Ejecutivo Nacional. (2026, 23 de mayo). Mensaje N.° 178/2026. Proyecto de ley de régimen de gestión de intereses. Honorable Cámara de Diputados de la Nación. https://rest.hcdn.gob.ar/web/tramites-parlamentarios/render/adjunto/6a158c0a5f3b6.pdf
Pogrebna, G. (2024, 9 de octubre). AI underpinned by developing world tech worker ‘slavery’. Asia Times. https://asiatimes.com/2024/10/ai-underpinned-by-developing-world-tech-worker-slavery/
Proceso. (2025, 18 de diciembre). Golpe al monopolio de Google y Android en México. Proceso. https://www.proceso.com.mx/economia/2025/12/18/golpe-al-monopolio-de-google-android-en-mexico-comision-obliga-abrir-el-mercado-de-telefonos-364964.html
PwC. (2026). PwC’s 2026 Global CEO Survey. PwC. https://www.pwc.com/gx/en/issues/c-suite-insights/ceo-survey.html
Rehak, R. (2025). AI narrative breakdown: A critical assessment of power and promise. En Proceedings of the 2025 ACM Conference on Fairness, Accountability, and Transparency (FAccT ’25). ACM. https://doi.org/10.1145/3715275.3732083
Reisner, A. (2025, 20 de marzo). The unbelievable scale of AI’s pirated-books problem. The Atlantic. https://www.theatlantic.com/technology/archive/2025/03/libgen-meta-openai/682093/
Reuters. (2025, 10 de octubre). OpenAI, Sur Energy weigh $25 billion Argentina data center project. https://www.reuters.com/world/americas/openai-sur-energy-weigh-25-billion-argentina-data-center-project-2025-10-10/
Ricaurte, P. y Roldán, T. (2025, julio). No es sequía, es saqueo: Querétaro, “el valle de los centros de datos”. TRAMAS — Tierra Común. https://tramas.digital/es/casos/queretaro/
Rötting, T. S., Mercado, M., García, M. E. y Quintanilla, J. (2014). Environmental distribution and health impacts of As and Pb in crops and soils near Vinto smelter, Oruro, Bolivia. International Journal of Environmental Science and Technology, 11, 935–948. https://doi.org/10.1007/s13762-013-0313-1
Schaffer, A., Oremus, W. y Tiku, N. (2026, 27 de enero). Inside an AI start-up’s plan to scan and dispose of millions of books. The Washington Post. https://www.washingtonpost.com/technology/2026/01/27/anthropic-ai-scan-destroy-books/
Skoknic, F. y Pizarro, G. (2025). Alfombra roja en Chile para los data centers: sin evaluación ambiental pero con mapa para invertir. CLIP / La Bot. https://www.elclip.org/alfombra-roja-en-chile-para-los-data-centers-sin-evaluacion-ambiental-pero-con-mapa-para-invertir/
Solow, R. M. (1987, 12 de julio). We’d better watch out. New York Times Book Review, 36. https://www.nytimes.com/1987/07/12/books/review/wed-better-watch-out.html (acceso con suscripción.)
Sonnenfeld, J. A. y Henriques, S. (2025, 8 de octubre). This is how the AI bubble bursts. Yale Insights. https://insights.som.yale.edu/insights/this-is-how-the-ai-bubble-bursts
Stanford HAI. (2026). 2026 AI Index Report. Stanford University Human-Centered Artificial Intelligence. https://hai.stanford.edu/assets/files/ai_index_report_2026.pdf
Sutty. (2024). Human Rights Defender organizations needs around digital communications and co-care [Documento de trabajo no publicado].
Sutty. (2026, 4 de marzo). Inteligencia artificial, acumulación primigenia, infraestructuras autónomas. https://sutty.nl/inteligencia-artificial-acumulación-primigenia-infraestructuras-autónomas/
Thompson, D. (2025, 2 de octubre). This is how the AI bubble will pop. Plain English. https://www.derekthompson.org/p/this-is-how-the-ai-bubble-will-pop
TrendForce. (2025, 1 de septiembre). 2Q25 foundry revenue surges 14.6% to record high, TSMC’s market share hits 70%. https://www.trendforce.com/presscenter/news/20250901-12691.html
USGS. (2024). Silicon; Quartz. En Mineral Commodity Summaries 2024. U.S. Geological Survey. https://pubs.usgs.gov/periodicals/mcs2024/mcs2024-silicon.pdf
USGS. (2024b). Copper. En Mineral Commodity Summaries 2024. U.S. Geological Survey. https://pubs.usgs.gov/periodicals/mcs2024/mcs2024-copper.pdf
USGS. (2024c). Bauxite and alumina. En Mineral Commodity Summaries 2024. U.S. Geological Survey. https://pubs.usgs.gov/periodicals/mcs2024/mcs2024-bauxite-alumina.pdf
VerWey, J. (2024). Tracing the emergence of extreme ultraviolet lithography. CSET, Georgetown University. https://cset.georgetown.edu/publication/tracing-the-emergence-of-extreme-ultraviolet-lithography/
Volenik, A. (2025, 16 de agosto). CEO says AI is taking on ‘soul-crushing jobs’ with agents that work 24/7. Yahoo Finance. https://finance.yahoo.com/news/ceo-says-ai-taking-soul-173137629.html
von Thun, M. y Colville, G. (2026). Taming the hyperscalers: A blueprint for an open, competitive, and sovereign European cloud market. Open Markets Institute. https://www.openmarketsinstitute.org/publications/report-rethink-regulatory-approach-to-essential-cloud
Wagner, M., Baldé, C. P., Luda, V., Nnorom, I. C., Kuehr, R. e Iattoni, G. (2022). Monitoreo regional de los residuos electrónicos para América Latina. UNU/UNITAR. https://ewastemonitor.info/regional-e-waste-monitor-for-latin-america-2022/
World Economic Forum. (2025, diciembre). From minerals to megawatts: Building resilience for EVs, data centres and power grids. White paper con Kearney. https://reports.weforum.org/docs/WEF_From_Minerals_to_Megawatts_2025.pdf
Xiao, T., Fuso Nerini, F., Matthews, H. D., Tavoni, M. y You, F. (2025). Environmental impact and net-zero pathways for sustainable artificial intelligence servers in the USA. Nature Sustainability, 8, 1541–1553. https://doi.org/10.1038/s41893-025-01681-y
Yotzov, I., Barrero, J. M., Bloom, N., Bunn, P., Davis, S. J., Foster, K. M., Jalca, A., Meyer, B. H., Mizen, P., Navarrete, M. A., Smietanka, P., Thwaites, G. y Wang, B. Z. (2026). Firm data on AI (NBER Working Paper No. 34836). NBER. https://doi.org/10.3386/w34836
Notas
| ↑1 | Incluida la conceptualización de Bratton (2016) de la computación planetaria como megaestructura de capas soberanas |
|---|